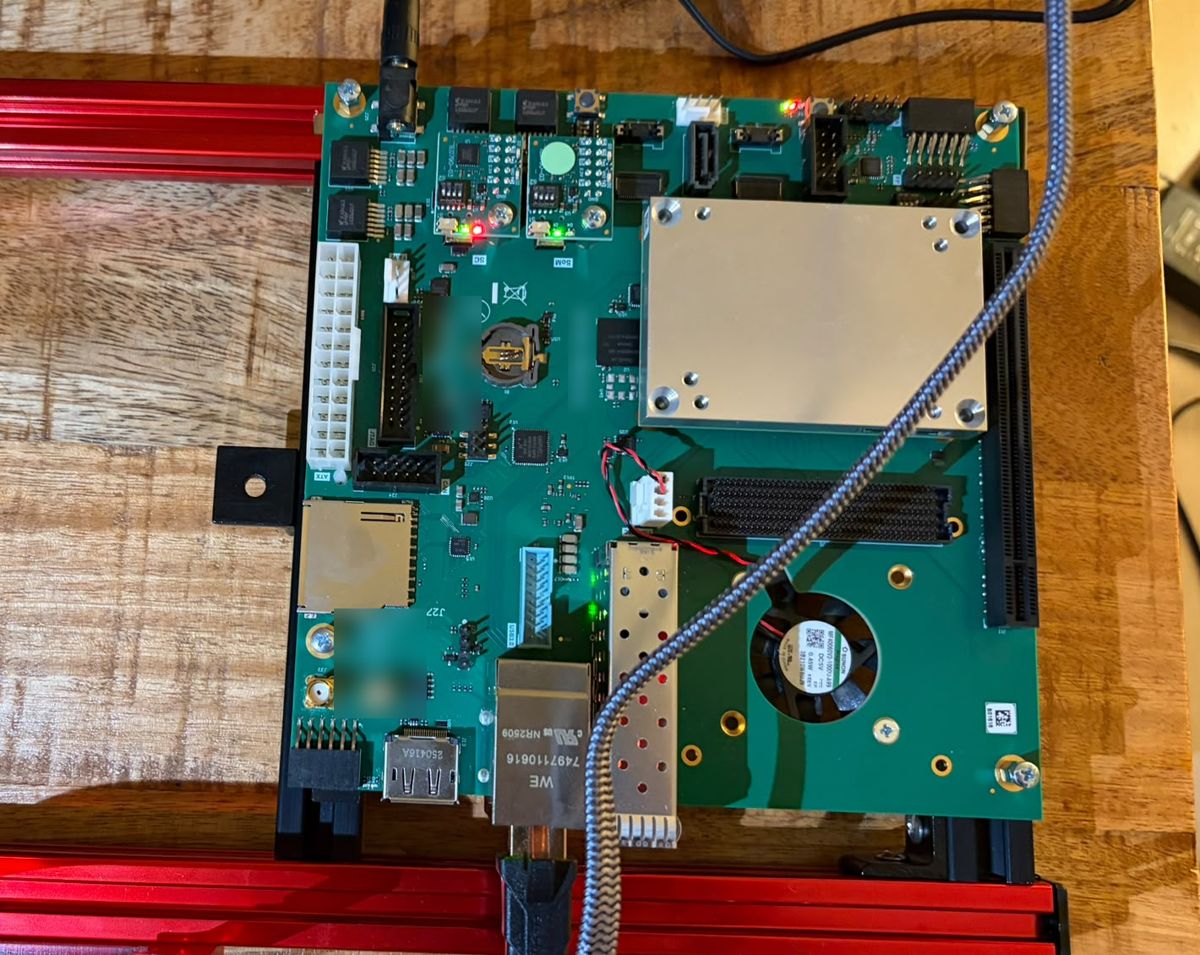
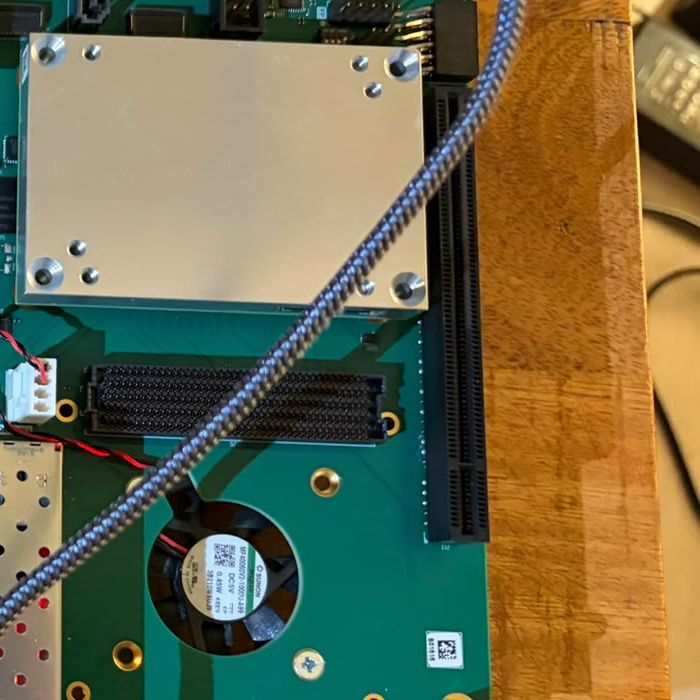
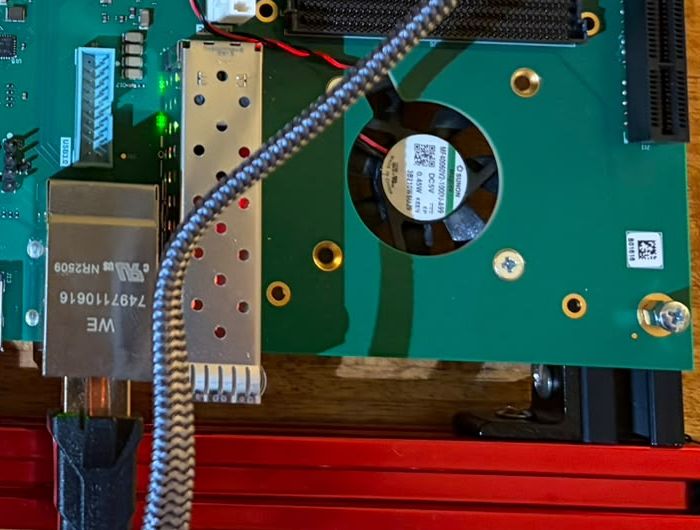
In den letzten Wochen war es still um NeuroVexon — weil wir gebaut haben. Vexon-1 läuft jetzt auf einer zweiten, größeren FPGA-Entwicklungsplattform. Und zum ersten Mal nicht mehr als einzelner NPU-Kern, sondern im Verbund: mehrere Rechenkacheln parallel auf einem FPGA, jede bit-exakt gegen unser Referenzmodell.
Dazu kommen ein doppelt so großes Rechenwerk pro Kachel, ein eigener RISC-V-Steuerkern, der neue Abläufe als Firmware statt als Hardware-Änderung ermöglicht, und ein eigenes Linux-Image mit eigenem Treiber-Stack. Alle fünf Kern-Innovationen sind über den echten Treiberpfad in Hardware nachgewiesen. Ende-zu-Ende rechnet die NPU eine typische Matrixmultiplikation 4,6-mal schneller als alle vier CPU-Kerne desselben Chips zusammen — gegen eine handoptimierte Bibliothek realistisch zwei- bis dreimal.
Warum das zählt: Wer Edge-KI-Hardware einsetzt oder lizenziert, will wissen, ob ein Design mitwächst — vom kleinen Sensor bis zur Fertigungslinie. Unsere Antwort ist kein Versprechen, sondern ein Messergebnis. Der nächste Schritt heißt Silizium.
Update-Video „Vom Kern zum Verbund“ (ca. 90 Sekunden).