Vexon-1
● FPGA-VERIFIZIERT
Technisches Profil des Vexon-1-NPU-Chip-Designs: Architektur, Kennzahlen und Verifikationsstand — gemessen auf zwei FPGA-Plattformen.
Was Vexon-1 ist
Vexon-1 ist ein spezialisierter Compute-Core für die Mathematik moderner Sprachmodelle — Matrix-Multiplikation, Attention, Akkumulation. Multi-Tile-Compute mit Hardware-Attention und On-Chip-KV-Cache.
Im Gegensatz zu generischen GPUs ist Vexon-1 für eine Aufgabe gebaut: Transformer-Inferenz auf dem Gerät. Das hält den Block klein und sparsam — und macht ihn als IP lizenzierbar für Anwendungen, in denen Daten das Gerät nicht verlassen dürfen.
Vexon-1 entdecken
Ein vereinfachtes 3D-Modell des Chip-Designs: Drehen Sie es, ziehen Sie es auseinander und wählen Sie eine Schicht, um zu sehen, was sie tut.
Ziehen zum Drehen · Schicht antippen oder mit Tab und Pfeiltasten wählen
Drei Kacheln rechnen gleichzeitig – bis zu drei sind heute parallel in Hardware validiert. Stilisiert: Daten kommen über AXI4 und den On-Chip-Bus in die Kacheln, der RISC-V-Kern steuert.
Wählen Sie eine Schicht, um mehr zu erfahren.
Unterlagen
Data Sheet, Design- und Test-Spezifikation: auf Anfrage unter NDA. Data Sheet anfragen →
Spezifikation
Die fünf Kern-Innovationen
Jede Innovation auf Hardware messbar — reproduzierbar via REST-API auf dem FPGA-Prototyp.
Sparse-Engine
Erkennt Null-Eingaben in Sprachmodellen und überspringt die Multiplikation. Weniger Strom, weniger Latenz, gleiche Mathematik.
Adaptive Precision
Schaltet die Genauigkeit adaptiv um, wenn die Daten es erlauben — höherer Durchsatz pro Takt.
Multi-Tile
Multiple Recheneinheiten arbeiten parallel — paralleler Durchsatz statt sequenzieller Berechnung.
Hardware-Attention
Der Transformer-Kern als dedizierte Zustandsmaschine in Hardware — inklusive Softmax und Zero-Score-Filter.
KV-Cache on-chip
Das Sprachmodell-Gedächtnis liegt direkt auf dem Chip statt im langsamen externen Speicher. Kein Cloud-Bedarf, kein DRAM-Roundtrip.
Verifikations-Status
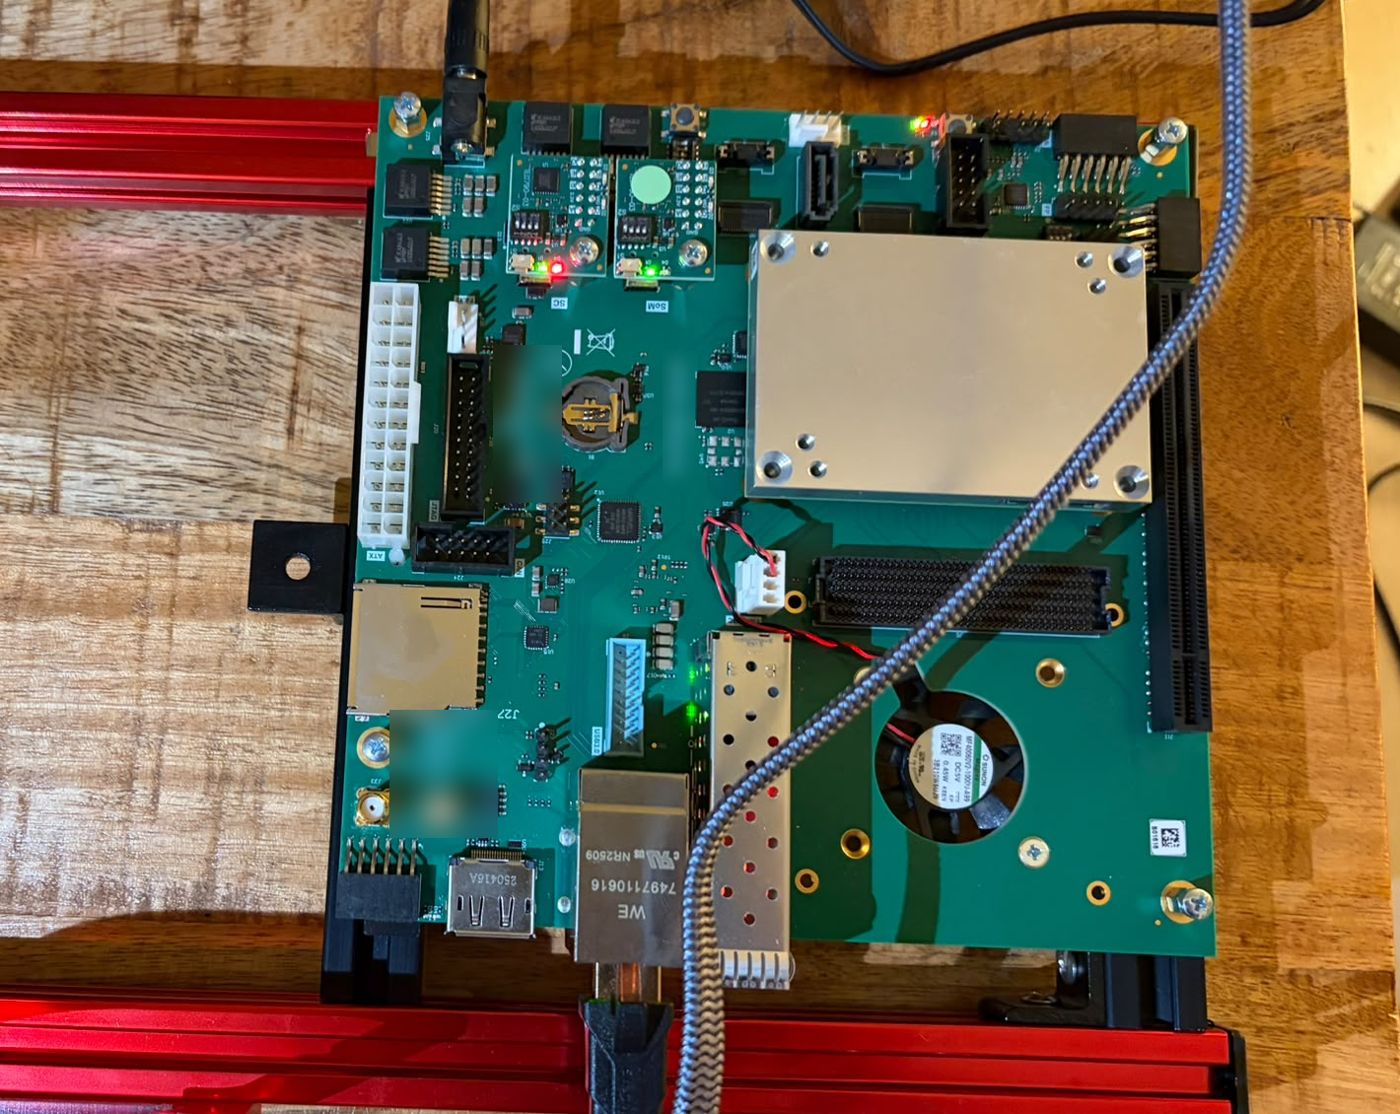
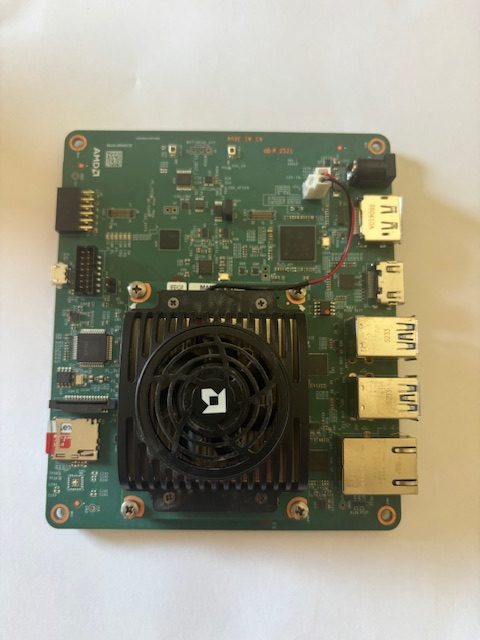
Vexon-1 läuft heute auf zwei FPGA-Plattformen: dem AMD Kria KV260 und einem größeren Zynq-UltraScale+-Baustein (ZU15EG). Alle fünf Kern-Innovationen sind über den echten DMA-Treiberpfad in Hardware nachgewiesen — bit-exakt gegen das Referenzmodell, mit einer 32×32-Kachel oder bis zu drei 16×16-Kacheln parallel. Gemessen wird direkt auf dem Zielsystem, ohne Host-PC im Datenpfad.
In der Simulation prüfen 14 parametrische Testbenches mit über 10.000 automatisierten Testfällen jede Konfiguration bit-exakt gegen ein Referenzmodell. Die Code-Coverage über das Kern-RTL liegt bei 92 %. Im Systemkontext rechnet die NPU eine typische Matrixmultiplikation Ende-zu-Ende 4,6-mal schneller als alle vier CPU-Kerne desselben Chips zusammen; das ordnet ein, ist aber kein Vergleich mit anderer NPU-IP. Die Verifikations-Pipeline ist die Grundlage für die ASIC-Stufe.
2
FPGA-Plattformen
3
Kacheln parallel, bit-exakt
92 %
Code-Coverage Kern-RTL
10.000+
Testfälle in 14 Testbenches
Erst der Anfang
Vexon-1 ist heute als FPGA-Prototyp verifiziert — angebunden über eine Standard-AXI4-Schnittstelle, wie sie in der Chip-Industrie üblich ist. Das macht den NPU-Block sauber in fremde SoC-Designs integrierbar.
Die modulare Multi-Tile-Architektur ist auf Skalierung ausgelegt: bis zu drei Kacheln rechnen heute parallel auf dem FPGA, jede bit-exakt, die Kachelzahl ist ein RTL-Parameter. Die nächsten Stufen sind größere Arrays im ASIC und Chiplet-Ansätze.
Skalierungs-Pfad — heute verifiziert, die weiteren Stufen sind Ziel bzw. Konzept.
Vexon-1 in Aktion sehen
Demo, technische Spezifikation oder Architektur-Gespräch — wir nehmen uns Zeit.